
推特热议「model」:API、AI、Astra
2026-11-11 的统计中,「model」在中文推特上有 26 条相关推文、24 位作者参与,累计浏览约 9万,当天 22 个热门话题中排第 22。讨论里出现最多的相关词是API、AI、Astra。我们收录的推文共获得 896 次点赞、回复、转发和引用,互动最高的一条来自 @tiny219_(231 赞、4 转发)。
「model」热门推文
按浏览量排序,展示前 10 条。
- 1
 xiax|AI & Agents@xiax0603 · 2026-11-10 20:23
🚨 官方文档实锤!GPT-6.2 Astra/Sol/Terra/Luna齐发?6.2家族信号再强化! ✧ OpenAI更新Responses API文档,compaction的instructions字段标注废弃,新增说明明确指向“6.2及更高版本模型” ✧ 文档采用复数models表述,与流传的astra/sol/terra/luna四档位6.2家族传闻形成对应 ✧ 6.2 Astra /Sol 相关爆料已流传数周未官宣,本次文档更新属于模型上线前的常规前置准备
- 2
 余温@gkxspace · 2026-11-11 11:06
最近跟一些做企业 AI、出海产品的朋友聊,发现很多人在偷着干: 拿 DSH 搞定制交付,同时赚底层 Token 的差价 为什么这路子现在这么爽? 因为以前你给客户交付一个聊天框,客户根本不会用。而 DSH 是 MIT 开源的,连界面和侧边栏全都是插件 你开 Creator Mode 让 AI 现场写个业务面板,或者直接装上社区现成的 dsh-media-desk、dsh-univer-office,改个 Logo 打包出去,客户看到的就是一套专属的桌面工作台(就这点,客单价直接翻几倍) 更爽的是后端的算力差价: DSH 跑多步任务和插件特别吃 Token,而客户自己去配各家官方 API 又贵又麻烦,你可以直接在 DSH 里赚差价, 比如,Custom model API 里接上 @HiLinkup_AI : 1、DeepSeek V4.1 Flash:冲多少送多少+日常 4.8 折,直接干到 2.4 折 2、插件要用的模型全打折:千问 3.8 全系和生图 7 折,还有 Seedance 2.0,Claude 5.5 也 7 折 3、而且后台自带 Model Routes,你在客户端里只写死一个模型 ID,后台绑多个备用渠道,哪家限流自动切哪家 把底层 Token 成本砍掉 70% 到 80%,前面收软件定制费,后面长期吃 Token 差价,很香~ HiLinkup🔗:https://t.co/pBbBXQxEt7 DSH 可视化插件市场🔗:https://t.co/xXuDqaNROn
- 3
 awe0@awe0_io · 2026-11-11 04:53
这周 GitHub 上暴涨的项目:dsh-our-free-model ⭐ 68.7k,6 天暴涨 8k(约 13%) DeepSeek Harness(dsh)的开源插件,安装后无需注册、无需 API Key,就能免费使用 DeepSeek V4.1 Flash、Kimi K3 等模型。请求会转发到 OpenCode 和 Kilo AI 的免费网关。 需要注意:「不限量」只是指不计费,用得太猛仍可能触发 429 限流;Kilo 免费池的提示词可能被上游记录,别提交机密信息或个人隐私。 https://t.co/MV7QUIe7Ha #开源 #GitHub #本周爆发
- 4
 Tiny(タイニー)🇹🇼🇯🇵@tiny219_ · 2026-11-11 14:49
第八屆百大女郎投票🗳️想不到我還在吧🤪 今年一樣是要奮戰到12/31最後一天! 請大家每天記得去JKFace把票投給我唷💓 #jkf百大女郎 #jkf #日系 #model #actress https://t.co/71PUV8UOBw
- 5
 Hao Zhang@HaoZhang623 · 2026-11-11 07:47
今天看到很多帖子说,Fable 5.2 一出来,Video Gen、3D Gen 这些方向都要被杀死了。我倒是没有这么悲观。 我觉得这里有一个很重要的区别:LLM 主要从人类产生的信息(语言)中学习如何理解世界,而 World Model 有机会更直接地从世界本身学习,不一定需要局限于人类的认知视角和表达方式。 换句话说,AI 理解和模拟世界,未必一定要遵循人类理解世界的方式。 那为什么现在 LLM 的通用能力比 Video Model / World Model 强这么多?我觉得一个主要的原因就是 Data。 理论上,如果有近乎无限的高质量视频数据,World Model 的泛化性和通用性完全可能比现在强得多。但现实是视频和 3D 数据远没有文本那么容易获取,所以短期内打不过 LLM 也不奇怪。 这里又想引用一个从 @jcjohnss 那里学到的观点:很多时候决定一条技术路线能否成功的,不是方法或原理本身的优劣,而是当前的资源条件是否适合这条路线。 这跟 The Hardware Lottery 的观点很像,而今天的 LLM 和 World Model 某种程度上也存在一个 Data Lottery。 反过来说,LLM 的通用能力再强,也不能完全绕过 Video Gen、3D Reconstruction 的数据瓶颈。没有足够的领域数据,某些能力就是有上限的。 更何况,现在 Astra / Fable 展示的很多能力也不是 End-to-End 的,而是借助 COLMAP、Blender 等工具来完成任务。LLM 学会调用 Blender,不等于它自己学会了生成 3D 世界。 我觉得现在的 LLM 很大程度上是在学习人类解决问题的方式:理解任务、制定计划、调用工具。但人类能站到食物链顶端,也不是因为自身什么都能做到最好,而是因为学会了创造和使用工具。工具的能力,很大程度上决定了最终结果的上限。 所以短期内,我觉得 LLM 仍然会是最重要的大脑,而 Video Model / World Model 会成为非常强悍的工具,两者结合可能才是最优解。 但长期来看,二者的关系会更加微妙。
- 6
 HiSeven|🕊️@hisevenih · 2026-11-11 13:27
别再傻傻地去买昂贵的海外 API Key 跑模型了! GitHub 登顶双榜第 1 的 dsh-our-free-model 搞了个相当霸道的本地网关方案:不让你填任何 Key,不让你绑定信用卡,直接把 DeepSeek V4.1 Flash、Kimi K3 和 GLM 5.3 打包成零门槛的免费前沿车道! 最绝的是它解决了深度思考模型最大的那个死穴:一旦思考时间太长断连,它能在本地 900 秒内自动触发有界恢复,把正文无缝补全。再加上 RTK 算法对 40KB 的 git diff 直接就地重写压缩 90% 冗余,上下文效率直接拉满。 别在繁琐的注册和订阅上浪费时间,把它挂进本地 CLI,白嫖免费前沿模型才是硬道理。 #AI工具 #DeepSeek #dsh GitHub https://t.co/hKRfgxTiMu
- 7
 江林山@J_Lingshan0909 · 2026-11-11 14:28
以我对中国政治的了解,我并不认为中国会单纯因为nous一次愚蠢的垃圾发表而应激,限制模型开源——“小小寰球,有几个苍蝇碰壁”,坚持AI技术的安全、开放、共享,使AI技术能够真正惠及人类命运共同体,是中国所敲定的大是方针,中国不会因为这点小事动摇国家战略。 但nous的行为,代表了一种极大的危险倾向——将纯粹的技术空间政治化,将无休止的人类主观争议,主动带入原本和谐的技术交流氛围。 仅从这一点上看,将nous research比做开源阵营里的特洛伊木马也毫不为过。 当nous大张旗鼓地在营销推文里使用“强化西方价值观”这种术语,试图把那些狗屁倒灶的政治争议包装成一个中立的技术议题摆上台面时,开源阵营最大的威胁者和破坏者也随之出现了。 对AI爱好者而言,nous此次的成果无非就是一句正确的废话——其所做的与lora微调没有本质区别,而这原本就并非什么高深莫测的技术。你有了权重、有了数据集,那你当然能通过后训练,将模型引导成更符合你需求的模样。 既然人们能通过后期的微调和注入破甲,让开源AI甚至是闭源AI,来生产色情内容、来进行黑客攻击,那让开源AI复述一些政治观点,吐出你想要的文字,又能是什么困难的工作? 不妨再好好回顾一下LLM的全称——Large Language Model,解决这种文本对话能力上的需求,本来就是人类发明LLM的一大初衷。 如此背景下,nous还冠冕堂皇地打着“去宣传化”的幌子,利用自己的影响力,把推行一套技术价值约等于0的价值观对齐样板当做什么成果发表,真可谓是其心可诛。 最后,我想再来谈一点政治。 如果中国现今的无条件慷慨,会被一些不怀好意的境外开发者利用,用来成组织地扩大对中国的抹黑与污名化;如果最后占据开源社区头版热议的,只是诸如nous的Arete这种无聊的宣传对齐垃圾。 那么中国完全有理由转向有限开放,仅向那些真正聚焦于技术的纯粹开发者、真正热爱开源事业的同志,提供开源便利。
- 8
 知一@xingzengji · 2026-11-11 12:44
卧槽!💥 GPT-6.2 Astra 应该快要发布了!! 在 OpenAI 刚刚更新的 Responses API 文档,出现了「models 6.2 及更高版本」的字样。 这回应该快了吧!!!🤔 https://t.co/K0vIsy04oA
- 9
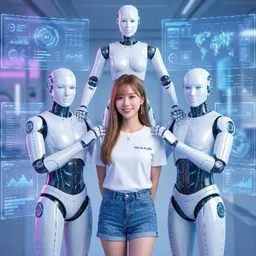 des.AI.Studio@desds1678 · 2026-11-11 15:33
今次比大家投下票😆 邊張相整體效果好啲? 之後我會開估用嘅image model https://t.co/QvvcsEWXZd
- 10
 Haoquan Zhang@Haoquan03 · 2026-11-11 08:09
让 llm 吃掉 segmentation, detection 以及 ocr 绝对不是llm for vision 的终点。我们应该把视角转向更广阔的视觉任务里 当所有人都认为视觉任务需要独特的 bias 的时候,最近发版的 llms 无一例外都证明了,极强的视觉理解和输出能力并非 cv model 的专属。 another bitter lesson for computer vision ....
主要参与作者
同一天的其他科技话题
数据通过推特数据接口从中文推特公开推文中采集,浏览和数量是快照时的数据,不是实时数值。 数据口径